Case study · AI agents / QA
Dashboard สำหรับทีม AI agents: เห็นว่าใครมอบงานให้ใคร แบบ live
ผมใช้ทีม AI agents ของ Claude Code ทำงานจริงทุกวัน มีทั้งเลขา, PM, Dev, QA และ Writer แต่ละตัวมอบงานต่อกันเป็นทอด ๆ ปัญหาคือมองไม่เห็นว่าตอนนี้ใครทำอะไร และงานไปติดอยู่ที่ใคร งานนี้จึงสร้าง dashboard แบบ live ขึ้นมาดู และใช้ทีม AI ชุดเดียวกันนั้นเป็นคนสร้าง โดยมีผมเป็นผู้ตรวจรับ
- บทบาท
- เจ้าของงาน: เขียน requirement, ตั้งเกณฑ์ตรวจรับ, ตัดสินใจเรื่อง trade-off และตรวจรับทุกรอบ
- ช่วงเวลา
- 11 ต.ค.–3 พ.ย. 2026 · 58 commits
- เครื่องมือ
- Claude Code (hooks, sub-agents), Node.js, Server-Sent Events, Three.js
ภาพหน้าจอทุกภาพสร้างจาก event สังเคราะห์ (demo) ไม่ใช่ข้อมูลการใช้งานจริง · โค้ดเขียนโดย AI agents (Claude) ภายใต้ requirement และการตรวจรับของผม · ระบบรันในเครื่องเท่านั้น ไม่ได้เปิดเป็นบริการ
ปัญหา
ทีม AI agents ทำงานเป็นสายโซ่ เลขารับคำสั่ง ส่งต่อให้ Dev แล้ว Dev ส่งต่อให้ QA ตรวจ ทั้งหมดเกิดขึ้นใน terminal เป็นข้อความยาว ๆ คนที่สั่งงานจึงตอบคำถามง่าย ๆ ไม่ได้ เช่น
- ตอนนี้ agent ตัวไหนกำลังทำงาน และมีงานเปิดอยู่กี่งาน
- งานนี้ใครเป็นคนมอบ และมอบให้ใครต่อ
- งานไหนค้าง หรือจบแบบล้มเหลว
- เวลาส่วนใหญ่หมดไปกับ agent ตัวไหน
Requirement
- เห็นแบบ live: แสดงว่าใครมอบงานให้ใคร และสถานะของแต่ละงาน (running / done / failed / stale) โดยรับข้อมูลจาก Claude Code hooks
- รีเฟรชแล้วข้อมูลไม่หาย: ปิดเปิดหน้าใหม่ หรือหลุดการเชื่อมต่อ ต้องได้สถานะเดิมกลับมาครบ
- ไม่เก็บข้อมูลอ่อนไหว: ไม่เก็บ prompt, transcript หรือเนื้อหาไฟล์ ข้อความที่เก็บต้องผ่านการ redact ก่อน
- ปลอดภัยแม้รันในเครื่อง: ต้องไม่ให้เว็บอื่นหรือโปรแกรมอื่นในเครื่องสั่งงานแทนเจ้าของได้
- ดูแลง่าย: ไม่มี dependency ภายนอก ไม่มี framework ไม่มี build step
- คนเป็นผู้อนุมัติ: คำสั่งที่ส่งจาก dashboard ต้องรอเจ้าของกดอนุมัติก่อนทุกครั้ง server ไม่เรียกโมเดลหรือรันคำสั่งเอง
วิธีทำงาน: ทีม AI เป็นคนสร้าง คนเป็นผู้ตรวจรับ
ผมไม่ได้เขียนโค้ดเอง แต่ทำหน้าที่แบบเดียวกับที่ทำในงาน QA และดูแลโปรเจกต์ คือแปลงความต้องการให้เป็นข้อกำหนดที่ตรวจได้ แล้วตรวจรับผลงาน
| ขั้น | ใครทำ | สิ่งที่ได้ |
|---|---|---|
| Requirement และเกณฑ์ตรวจรับ | ผม | ขอบเขตงานต่อรอบ และเกณฑ์ว่าผ่านหรือไม่ผ่าน |
| เขียนโค้ดและ tests | Dev agent | โค้ดพร้อม tests ทุกครั้งที่แก้ |
| รีวิวและหา defect | QA agent (อ่านอย่างเดียว แก้โค้ดไม่ได้) | รายการ finding ที่มีรหัส เช่น F1–F8 ส่งกลับให้ Dev แก้ |
| ตรวจรับ | ผม | ดูผลจริงบนหน้าจอ อ่านรายงาน แล้วตัดสินว่าจะ merge หรือส่งกลับ |
การแยกให้ QA agent แก้โค้ดไม่ได้ เป็นการตั้งใจ จะได้เป็นคนตรวจที่เป็นอิสระจากคนเขียน เหมือนการแยกทีม QA ออกจากทีม dev ในงานจริง
สิ่งที่สร้าง
- เก็บข้อมูล: hook ของ Claude Code เขียน event ลงไฟล์ JSONL บรรทัดละหนึ่ง event โดยตัดข้อความให้สั้นและ redact ก่อนเก็บ
- Server: Node.js ล้วน อ่านเฉพาะส่วนที่ต่อท้ายใหม่ของไฟล์ แล้วส่งให้หน้าเว็บผ่าน Server-Sent Events
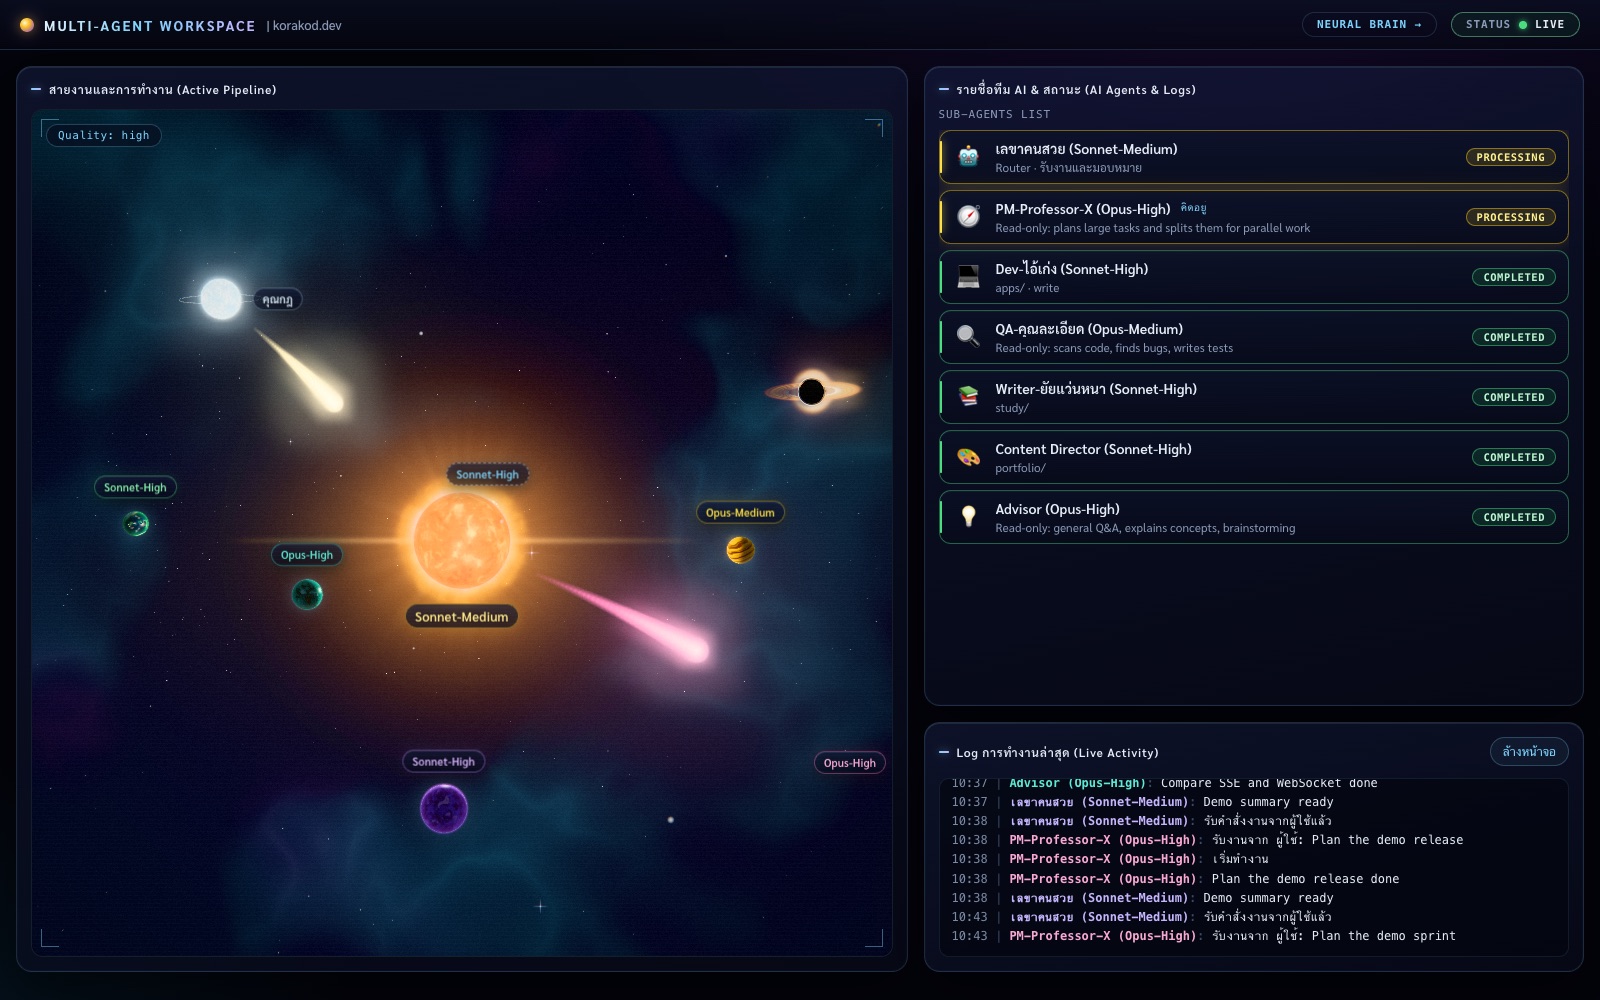
- หน้า Workspace: ฉาก 3D (Three.js ที่เก็บไว้ในโปรเจกต์ ไม่โหลดจาก CDN) ดวงจันทร์แทนงานที่ agent ทำพร้อมกัน และลำแสงสีต่าง ๆ แทนชนิดของ tool ที่ใช้
- หน้า Neural Brain: ภาพรวมสถิติ เช่น agent ที่ทำงานอยู่, อัตรา event, ภาระงานต่อ agent และ heatmap รายชั่วโมง
- Fallback: เครื่องที่ไม่มี WebGL จะเห็นเป็นรายการหรือภาพ 2D ที่มีข้อมูลครบเท่ากัน
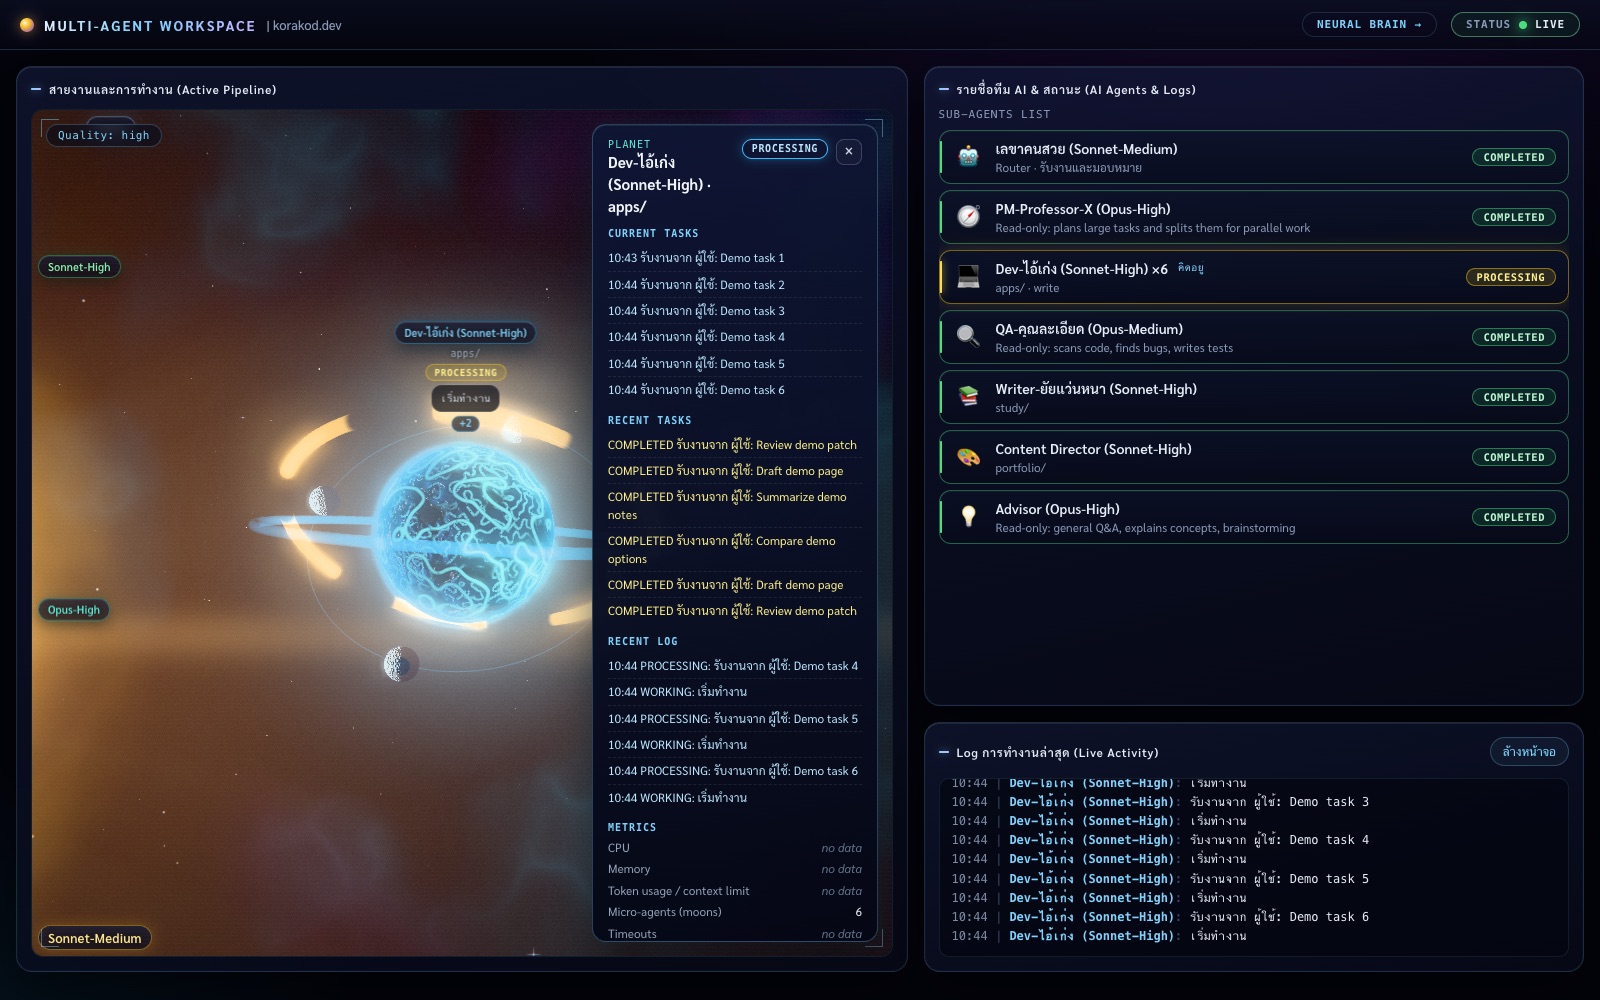
+2 และ HUD แสดงงานที่เปิดอยู่ทั้งหมด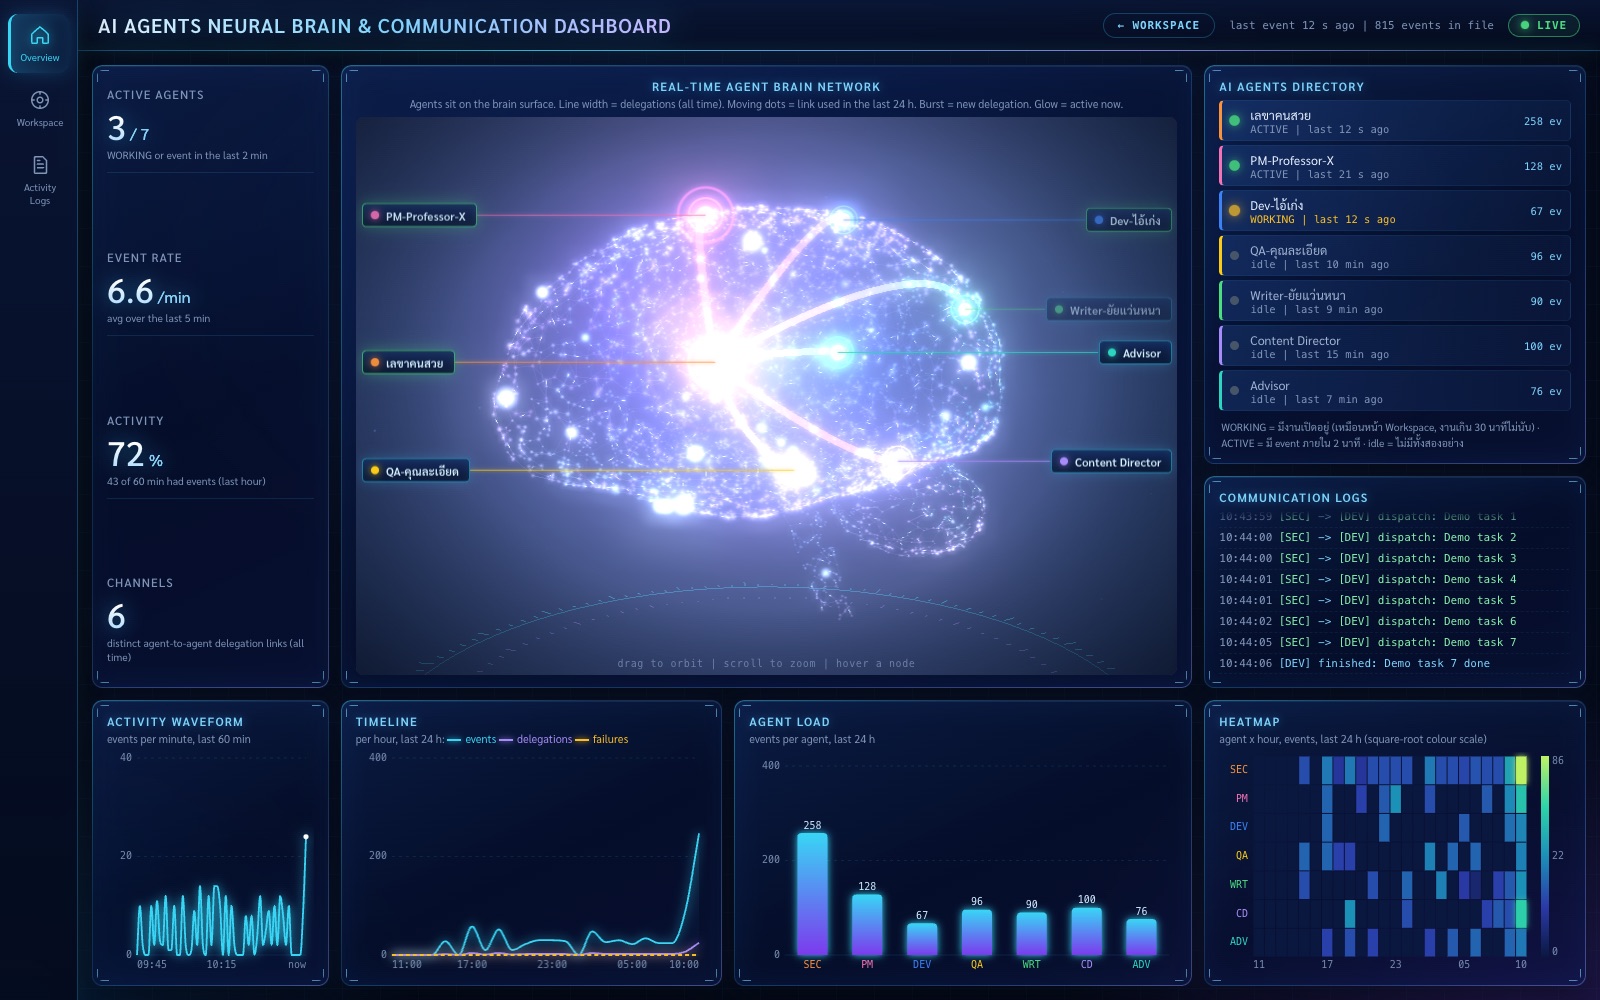
Security และ privacy
แม้จะรันในเครื่องตัวเอง แต่ dashboard รับคำสั่งเข้าคิวงานของ AI ได้ จึงต้องกันไม่ให้ใครสั่งงานแทนได้
| ความเสี่ยง | การป้องกัน |
|---|---|
| เครื่องอื่นในเครือข่ายเข้าถึง | bind ที่ 127.0.0.1 เท่านั้น |
| DNS rebinding และเว็บอื่นยิง request เข้ามา | ตรวจ Host และ Origin ทุก request ไม่ตรงได้ 403 |
| โปรแกรมอื่นในเครื่องสั่งงานแทน | POST ทุก route ต้องมี token ที่สุ่มใหม่ทุกครั้งที่ start server |
| Script แปลกปลอมในหน้าเว็บ | CSP แบบ default-src 'self' ไม่มี inline script ใช้ textContent แทน innerHTML และเสิร์ฟเฉพาะไฟล์ใน whitelist |
| ข้อมูลลับหลุดลง log | ไม่เก็บ prompt และ transcript ข้อความที่เก็บถูกตัดสั้นและ redact token, key, email และชื่อโฟลเดอร์ home |
| AI รันคำสั่งเองโดยไม่ได้รับอนุญาต | คำสั่งจาก dashboard เข้าคิวเป็น pending_approval ก่อนเสมอ ต้องให้เจ้าของกดอนุมัติ |
ข้อจำกัดของการ redact เขียนเปิดเผยไว้ในเอกสารของโปรเจกต์ด้วย เช่น my pass is hunter2 ที่ไม่มี : หรือ = จะไม่ถูกจับ
Defect ที่เจอและการแก้
| อาการ | สาเหตุ | การแก้ |
|---|---|---|
| Agent ค้างสถานะ PROCESSING ทั้งที่ไม่ได้ทำงาน | มีการเรียก agent ที่ไม่เคยเริ่มทำงานจริง แต่ dashboard นับเป็นงานที่เปิดอยู่ | ไม่นับการเรียกที่ไม่มี event เริ่มงานตามมา |
| เปิดหลาย session พร้อมกันแล้วหน้าจอล้างตัวเองสลับไปมา | server ตาม "session ล่าสุด" ตัวเดียว | เปลี่ยนเป็นกลุ่ม session ที่ทำงานซ้อนเวลากัน (epoch) session ใหม่ที่เข้ามาระหว่างนั้นเข้าร่วมกลุ่มเดิม ไม่ล้างหน้าจอ |
หลัง /clear เลขาดูว่าง ทั้งที่ยังมีงานค้างในคิว | event "รับงานเข้าคิว" ถูกตัดทิ้งไปพร้อม epoch เก่า | ยกสถานะคิวปัจจุบันเข้า epoch ใหม่ในหน่วยความจำ โดยไม่เขียนอะไรเพิ่มลง log |
| เส้นจากเจ้าของขึ้นทุกครั้งที่ sub-agent ส่งผลกลับ | ผลที่ส่งกลับเข้ามาเป็น prompt หน้าตาเหมือนคำสั่งของคน | แยก prompt ที่มาจาก agent ด้วยช่วงเวลาหลัง sub-agent จบ (2 วินาที) |
ค่าที่ใช้ตัดสินใจมาจากข้อมูลจริง ไม่ได้เดา เช่น เวลาที่ถือว่า session เงียบไปแล้ว ตั้งไว้ 60 นาที เพราะวัดจาก log จริง 66 sessions แล้วพบว่าช่วงเงียบตอนรอ sub-agent ยาวสุด 33.2 นาที ถ้าตั้ง 30 นาทีจะตัด session ที่ยังทำงานอยู่
ผลลัพธ์
- Tests 881 ข้อ ผ่านทั้งหมด ด้วย
node:testใช้เวลารันราว 10 วินาที ครอบคลุม unit, HTTP/SSE, security และการรันโค้ดหน้าเว็บจริงใน VM - ไม่มี dependency ใน
package.jsonเลย ใช้ Node.js built-ins ทั้งหมด - ใช้งานจริง กับทีม AI ของผมตั้งแต่ ต.ค. 2026 และเมื่อเพิ่ม agent ตัวใหม่เข้าทีม มี test กันไม่ให้ agent ใหม่ตกหล่นจากหน้าใดหน้าหนึ่ง
ใช้ข้อมูลจาก dashboard หาคอขวดของทีม
เมื่อมี log แล้ว ผมให้วิเคราะห์เวลาจากข้อมูลจริง 4 วัน (3,580 events, 276 งานของ sub-agent) ได้ผลที่ไม่ได้คาดไว้
| ข้อค้นพบ | ตัวเลข |
|---|---|
| คอขวดคือ Dev agent | 142 งาน รวม 9 ชม. 32 นาที = 78.8% ของเวลาที่ agent ทั้งทีมทำงาน |
| งานยาวไม่กี่งานกินเวลาส่วนใหญ่ | งาน Dev ที่เกิน 10 นาทีมี 18 งาน แต่รวมเป็น 45% ของเวลาทั้งหมด |
| เลขาไม่ใช่คอขวด | ส่งต่อผลงานเฉลี่ย 8.8 วินาที รวมแค่ 1.7% ของเวลา |
| แทบไม่ได้ทำงานคู่ขนาน | เวลาที่งานซ้อนกันรวมไม่ถึง 5 นาที จาก agent time ราว 12 ชม. |
ข้อสรุปที่นำไปใช้: ถ้าจะให้ทีมเร็วขึ้น ต้องแตกงาน Dev ที่ใหญ่ให้เล็กลง และแบ่งให้รันคู่ขนาน ไม่ใช่ไปปรับที่เลขา
ข้อจำกัด
- Sub-agent ที่จบแบบไม่สำเร็จจะแสดงเป็น done เพราะ hook ไม่ได้ส่งสถานะ error มาให้
- เมื่อมีหลาย session พร้อมกัน การจับคู่งานบางกรณียังใช้ heuristic และอาจสลับงานของ agent ชนิดเดียวกัน
- ตัวเลขการวิเคราะห์เวลามาจากผู้ใช้คนเดียวในช่วง 4 วัน ใช้เป็นตัวอย่างของวิธีคิด ไม่ใช่ benchmark
สิ่งที่นำไปใช้กับงาน QA ได้
- ทีม AI ทำงานได้ดีเมื่อมี requirement ชัดและเกณฑ์ตรวจรับที่วัดได้ เหมือนทีมคน
- แยกคนตรวจออกจากคนเขียน แม้ทั้งสองฝั่งเป็น AI
- ตั้งค่าและตัดสินใจจากข้อมูลจริง และเปิดเผยข้อจำกัดไว้ในเอกสาร